Говорящий портрет: почему губы не всегда попадают в звук и как нейросети это исправляют
Говорящий портрет: что это такое и где он уже пригодится
Говорящий портрет — это видео, где статичное фото человека начинает двигаться: мимика, моргание, повороты головы и артикуляция губ. 🎬 Такие ролики создают нейросети: они берут изображение и аудиодорожку, а затем синтезируют промежуточные кадры. На выходе получается эффект, будто человек действительно произносит текст. Но именно губы чаще всего выдают искусственное происхождение.
Зачем это нужно? 🎯 Блогерам — для быстрых анонсов, преподавателям — для озвучки слайдов, бизнесу — для персонализированных поздравлений. Можно не переснимать видео, если изменился только текст. Достаточно загрузить портрет и аудио. Однако чем сложнее сценарий, тем заметнее рассинхрон. Поэтому важно понимать, откуда берутся ошибки.
Пользователи часто ждут идеального результата с первого клика. 🤔 Но говорящий портрет — это не магия, а вероятностная модель. Она предсказывает, как должна выглядеть форма рта в конкретный момент. Если звук нечёткий или лицо повёрнуто, предсказание становится менее уверенным. Тогда губы начинают «плыть» относительно речи.
Хорошая новость в том, что большинство проблем решаются на этапе подготовки. 📸 Чем чище исходники, тем меньше нейросети приходится додумывать. В этой статье разберём причины рассинхрона, проверенные приёмы и то, как современные сервисы вроде ZUZU AI помогают получить аккуратный говорящий портрет.
Как нейросеть связывает звук и движение губ
На первом этапе модель анализирует аудио. 🎧 Она разбивает дорожку на короткие фрагменты и выделяет фонемы — базовые звуковые единицы. Затем сопоставляет их с виземами, то есть визуальными образами губ и рта. Например, звук «п» требует смыкания губ, а «ф» — лёгкого касания зубами нижней губы.
Параллельно нейросеть изучает лицо на фото. 🧠 Она находит ключевые точки: уголки рта, верхнюю и нижнюю губу, челюсть, язык в видимых зонах. Модель строит внутреннее представление лица и пытается сохранить его неизменным. Это сложно, ведь при разговоре меняются тени, складки и даже форма щёк.
Дальше начинается синтез кадров. 🎞️ Для каждого мгновения аудио создаётся новое положение губ и нижней челюсти. Если частота кадров видео ниже частоты звуковых изменений, зритель может заметить отставание. Иногда модель просто не успевает перестроить форму рта между двумя соседними фонемами.
Важно, что нейросеть не «слышит» смысл. 👂 Она работает с акустическими признаками и статистикой. Поэтому быстрая речь, шёпот или сильный акцент сбивают её сильнее, чем размеренное чтение. Чем ближе манера говорящего к типичной обучающей выборке, тем точнее совпадение.
Почему рассинхрон возникает даже у хороших моделей
Первая причина — неоднозначность артикуляции. 👄 Многие звуки выглядят одинаково со стороны. По форме губ «ба» и «па» почти не отличаются, а «ма» и «ба» могут быть похожи в быстром темпе. Модель выбирает наиболее вероятный вариант, но иногда ошибается.
Вторая причина — задержка аудио. ⏱️ Если дорожка начинается с паузы или в ней есть лишние миллисекунды тишины, синхронизация сдвигается. Нейросеть может начать движение губ раньше или позже первого слова. Особенно заметно, когда человек резко начинает говорить после тишины.
Третья причина — сложные ракурсы. 📐 Если лицо повёрнуто в профиль, часть рта скрыта. Модель не видит, как именно движется дальняя губа, и достраивает её по догадке. В анфас результат обычно точнее, потому что обе губы и челюсть хорошо различимы.
Четвёртая причина — ограничения разрешения. 🔍 На маленьком или размытом фото мало деталей. Нейросеть не может точно определить контур губ и создаёт «пластилиновую» артикуляцию. Тогда даже идеальный звук не спасёт: движения выглядят обобщённо и не попадают в тонкие нюансы.
Совет: перед генерацией прослушайте аудио в наушниках и отметьте места, где речь сливается. 🎧 Если вы сами не разбираете слова, нейросеть тоже может ошибиться. Упростите фразу или сделайте паузу — синхронизация станет точнее.
Качество исходного фото: незаметный, но главный фактор
Для говорящего портрета лучше всего подходит чёткое фронтальное фото. 📷 Лицо должно занимать заметную часть кадра, но не обрезаться по подбородку или макушке. Чем больше пикселей приходится на рот, тем точнее модель построит движение губ. Поэтому не стоит выбирать снимок издалека.
Освещение тоже играет роль. 💡 Мягкий ровный свет без жёстких теней помогает нейросети увидеть естественные контуры. Если половина лица в тени, модель может неверно оценить глубину рта. Вспышка в лоб создаёт блики, которые тоже мешают анализу.
Выражение лица должно быть нейтральным. 😌 Улыбка во все зубы или приоткрытый рот на исходнике усложняют задачу. Модели приходится сначала «закрывать» рот, а потом заново открывать его под речь. Нейтральное выражение даёт более предсказуемую отправную точку.
Не стоит использовать фото с фильтрами, сильной ретушью или неестественной кожей. 🧴 Нейросеть может принять артефакты за реальные детали. В итоге на видео появятся странные складки, а губы будут двигаться неравномерно. Оригинальный снимок почти всегда лучше «улучшенного» автокоррекцией.
Звук решает не меньше, чем лицо
Даже идеальное фото не спасёт, если аудио записано плохо. 🎙️ Фоновый шум, эхо, гул компьютера и музыка сбивают анализ фонем. Нейросеть может принять посторонний звук за часть речи и добавить лишнее движение губам. Особенно вредны шумовые дорожки с постоянным гулом.
Громкость должна быть ровной. 🔊 Если вы то шепчете, то кричите, модель теряет стабильность. Лучше записать дорожку с одинаковым уровнем и без резких перепадов. Можно использовать простой нормализатор громкости, если он есть в редакторе.
Темп речи тоже важен. 🗣️ Слишком быстрая подача не даёт модели времени на плавную интерполяцию. Губы начинают «дёргаться» или отставать. Чем размереннее фраза, тем естественнее выглядит говорящий портрет. Иногда стоит сознательно замедлиться на сложных словах.
Паузы между словами — не враг, а помощник. ⏸️ Они дают нейросети точки опоры и помогают синхронизировать начало фраз. Если вырезать все паузы, речь станет плотной, а артикуляция — рваной. Оставьте небольшие естественные остановки.
| Причина | Что замечает зритель | Как снизить риск |
|---|---|---|
| Нечёткое аудио | Губы двигаются невпопад, появляются лишние открывания | Запишите звук без шума, эха и музыки |
| Быстрая речь | Артикуляция отстаёт или дёргается | Снизьте темп, добавьте короткие паузы |
| Поворот головы | Дальняя губа выглядит застывшей или размытой | Используйте фронтальное фото |
| Мелкое или размытое фото | Рот выглядит пластилиновым | Возьмите чёткий снимок с крупным лицом |
| Паузы и тишина в начале | Губы начинают движение раньше звука | Обрежьте лишнюю тишину до первого слова |
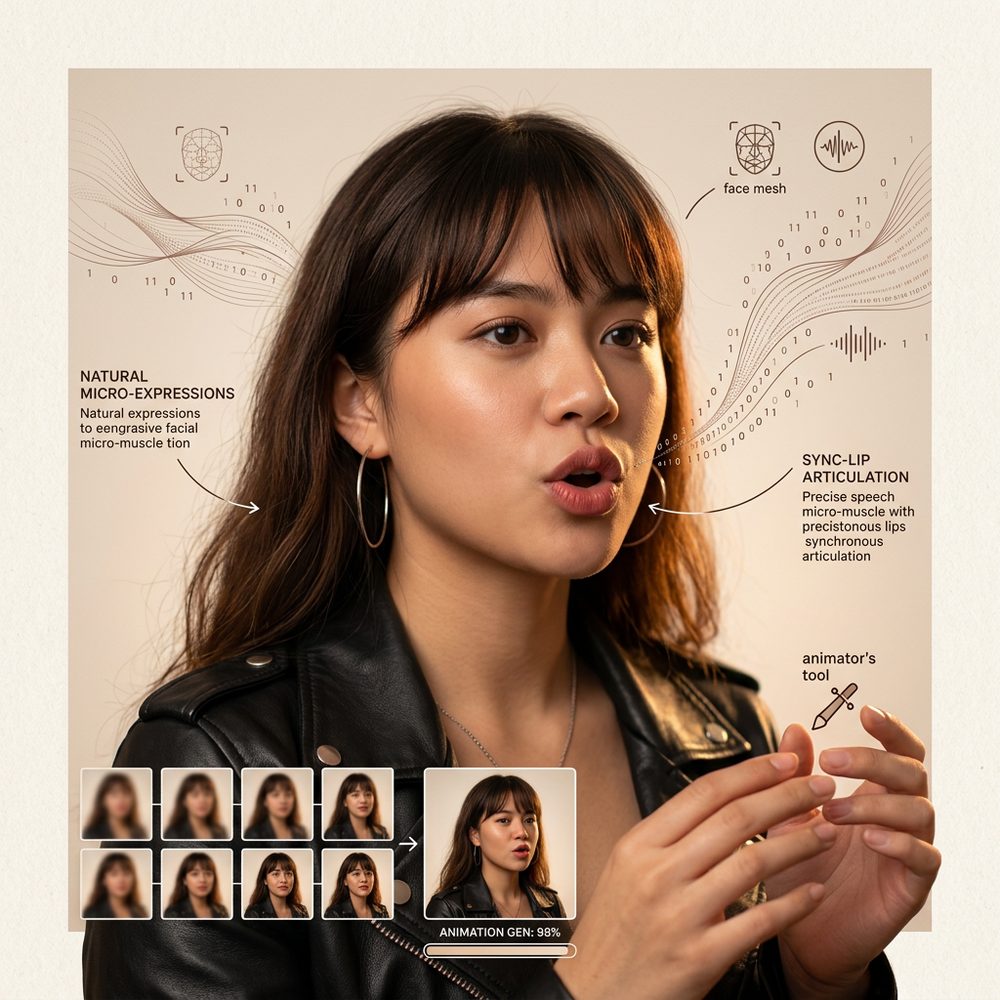
Артикуляция, язык и акцент: где модель слышит не то
Язык влияет на артикуляцию сильнее, чем кажется. 🌍 В русском, английском и азиатских языках губы работают по-разному. Если модель обучалась преимущественно на одной языковой группе, она может путать непривычные сочетания звуков. Особенно это заметно на носовых и шипящих.
Акцент добавляет вариативность. 🗺️ Один и тот же текст два человека произнесут с разной мимикой. Нейросеть пытается усреднить эти patterns, но иногда выбирает не тот шаблон. В результате губы двигаются по «среднему» сценарию. Из-за этого могут возникать странные поджатия и растягивания.
Диалекты и индивидуальные особенности тоже имеют значение. 🎭 Кто-то говорит почти не разжимая губ, кто-то активно артикулирует. Модель не знает вашей манеры, если вы не дали ей достаточно подсказок. Поэтому первый результат может казаться «не вашим».
Если важна точность, выбирайте язык озвучки в настройках, если сервис это поддерживает. 🧩 Это не гарантия идеала, но снижает число ошибок. Также помогает более чёткая дикция без нарочитого переигрывания. Главное — не менять язык посреди короткой фразы без необходимости.
Сценарии, в которых рассинхрон особенно заметен
Крупный план лица — самый строгий тест. 🔎 Когда рот занимает пол-экрана, зритель мгновенно замечает несовпадение. В общем плане или на среднем расстоянии мелкие огрехи почти не видны. Поэтому для важных роликов лучше тестировать именно крупный план.
Пение и эмоциональная речь сложнее обычного монолога. 🎵 Мелодия растягивает гласные, а эмоции меняют форму рта. Нейросеть может не успевать за быстрыми переходами. Для песен лучше использовать специализированные инструменты, а не обычный говорящий портрет.
Смена языка внутри одной фразы — отдельный вызов. 🔄 Если вы переходите с русского на английский, артикуляция меняется на ходу. Модель может «застрять» на предыдущем языке и показать неверные движения. Дробите такие фразы на короткие фрагменты.
Быстрые скороговорки и технические термины дают больше ошибок. 🧪 Сложные сочетания согласных требуют точной работы языка и губ. Если нейросеть не видит язык, она додумывает. Помогает замедление темпа и разбивка длинных терминов на слоги.
Как проверить и улучшить результат без студии
Начните с короткого теста на 5–10 секунд. ✅ Так вы быстро поймёте, подходит ли фото и звук. Не нужно сразу генерировать длинный ролик. Если на коротком фрагменте губы попадают в звук, длинный получится стабильнее. Это экономит время и помогает сравнить несколько вариантов.
Смотрите видео без звука. 👀 Так рассинхрон виден лучше: глаза замечают несоответствие до того, как мозг оправдает его смыслом. Если без звука артикуляция выглядит странно, со звуком будет ещё заметнее. Проверьте также ускоренное и замедленное воспроизведение.
Проверьте первые и последние секунды. 🎬 Именно там чаще всего возникает сдвиг из-за пауз. Если начало «плывёт», обрежьте лишнюю тишину. Если конец отстаёт, добавьте небольшую паузу после последнего слова. Эти простые правки убирают половину заметных ошибок.
Если сервис позволяет, попробуйте разные фото и разную громкость. 🛠️ Иногда достаточно заменить снимок на более чёткий, и результат улучшается. Также помогает замедлить аудио на 5–10% перед загрузкой. После генерации скорость можно вернуть в редакторе.
Хотите проверить говорящий портрет на своём фото? 🌟 В ZUZU AI можно сгенерировать новые изображения с лицом до 2K и оживить фото в видео со звуком до 2K. Загрузите портрет и аудио, чтобы увидеть, как работает синхронизация губ.
Что ждать от технологии завтра и как использовать сегодня
Технология говорящих портретов быстро развивается. 🚀 Модели учатся на больших данных, лучше понимают контекст и мимику. Скоро рассинхрон станет реже, но полностью не исчезнет. Всегда будут сложные языки, шёпот и нестандартные ракурсы. Поэтому навык готовить исходники останется полезным.
Уже сегодня можно получать аккуратные ролики, если подходить к процессу как к съёмке. 🎯 Подготовьте фото, запишите чистый звук, выберите нейтральную подачу. Тогда нейросети останется меньше догадок. А значит, губы будут двигаться увереннее. Не бойтесь делать несколько дублей озвучки.
Для быстрого старта удобно использовать сервисы, где генерация собрана в одном окне. 💻 Например, ZUZU AI создаёт изображения по фото до 2K и оживляет снимки в видео со звуком до 2K. Это помогает проверить идею без сложного пайплайна. Вы загружаете портрет и аудио, а результат получаете в понятном интерфейсе.
Главный совет — не гонитесь за идеалом с первого раза. 🔄 Сделайте короткий тест, посмотрите без звука, поправьте аудио и фото. После двух-трёх итераций результат обычно становится заметно лучше. Говорящий портрет — это инструмент, который любит аккуратный подход.
📚 Читайте также по теме «Видео со звуком»
✨ Попробуйте ZUZU AI
Создаёт новые фото по вашему лицу и оживляет снимки в видео — прямо на сайте, без установки программ. Результат в качестве до 2K.