Говорящий портрет с голосом: как это устроено на самом деле
Что такое говорящий портрет и почему это уже не спецэффект из кино
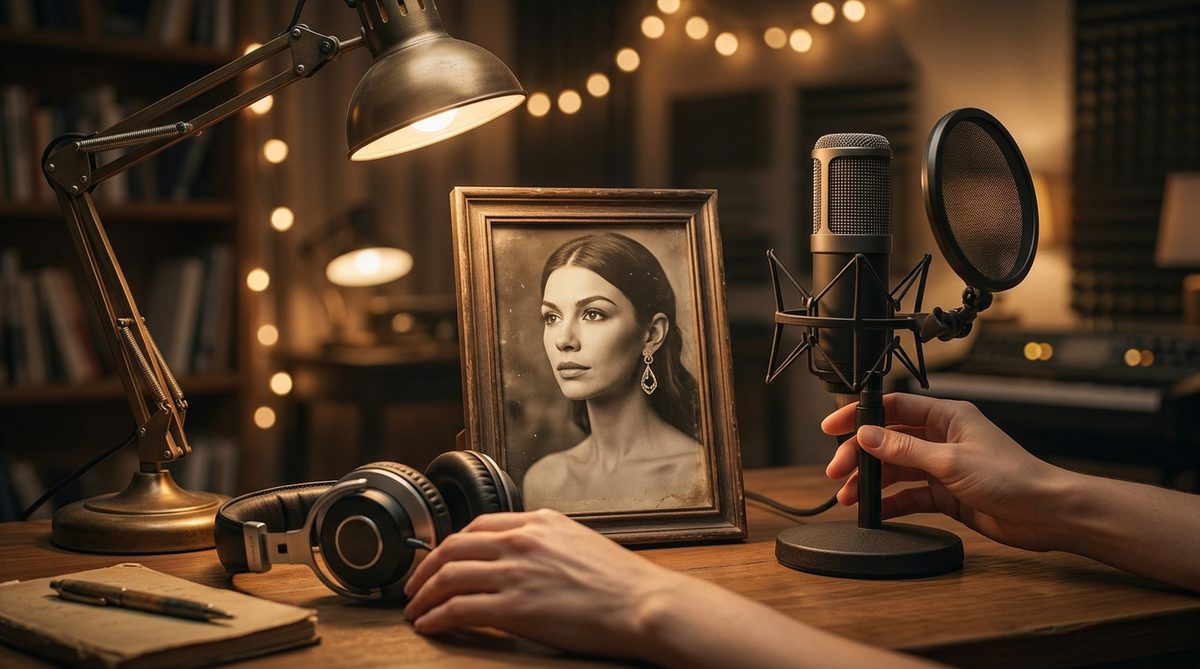
Говорящий портрет — это видео, где лицо с обычной фотографии двигается, моргает и произносит текст, а губы попадают в звук. Ещё пять лет назад такой кадр стоил как рекламный ролик, потому что его собирали вручную покадрово. Сегодня это делает нейросеть, и у вас уходит на это несколько минут.
Работает это не по волшебству. Модель обучена на огромном количестве видео с людьми: она знает, как выглядят губы при звуке «п», как двигаются брови при вопросе, как кожа ведёт себя при повороте головы. Фото для неё — это точка отсчёта, каркас, на который накладывается движение.
📷 Главное отличие от простой анимации — в связке «звук плюс лицо». Обычная гифка просто двигает картинку, а здесь звуковая дорожка управляет мимикой: громче фраза — активнее артикуляция, пауза — лицо успокаивается. Из-за этого ролик выглядит живым, а не нарисованным.
Второй слой — разрешение. Раньше оживление фото давало мягкую, «мыльную» картинку, которую стыдно показать на большом экране. Сейчас встречаются решения, отдающие результат вплоть до 2K, и такой ролик уже можно вставлять в презентацию, на сайт или в вертикальную ленту соцсетей.
Как нейросеть находит лицо и удерживает его в кадре
Первый шаг любой такой системы — детекция лица. Нейросеть сканирует фото и находит ключевые точки: зрачки, кончик носа, уголки губ, линию челюсти. Обычно это несколько десятков точек, и по ним строится трёхмерная модель головы, пусть и упрощённая.
🧩 Дальше начинается самое интересное — реконструкция. По одной фотографии модель достраивает то, чего на снимке не видно: затылок, уши в профиль, шею. Она не «знает» вашего лица, она опирается на статистику тысяч похожих лиц и предлагает правдоподобную версию.
Поэтому так важен ракурс. Если на фото человек смотрит строго в камеру и голова не наклонена, система работает уверенно. Профиль, сильный наклон или половина лица в тени — и модель начинает додумывать детали, которые легко заметить при внимательном просмотре.
Ещё один нюанс — удержание лица между кадрами. Видео это десятки последовательных изображений, и если каждое генерировать отдельно, лицо начнёт «плыть»: то худеет, то меняет форму глаз. Поэтому модель запоминает признаки и переносит их из кадра в кадр.
Синхронизация губ со звуком: самая сложная часть
Синхронизация — то, по чему зритель мгновенно определяет подделку. Человеческий мозг отлично считывает несоответствие между звуком и артикуляцией, даже если не понимает, что именно не так. Достаточно расхождения в пару кадров — и возникает то самое «неживое» ощущение.
👄 Чтобы этого избежать, модель переводят аудио в набор фонем — минимальных звуковых единиц — и сопоставляют их с формой рта. Звук «м» требует сомкнутых губ, «а» — открытого рта, «ф» — лёгкого касания нижней губы к зубам. Таких соответствий в модели десятки.
Дальше включается темпоритм. Если фраза сказана быстро, губы должны успевать за ней, а не «жевать» в замедленном режиме. Поэтому хорошие сервисы анализируют не только сами фонемы, но и их длительность, паузы, громкость и даже интонационные перепады внутри предложения.
Отдельная головная боль — язык. Модели, обученные на английском, на русской речи спотыкаются: артикуляция другая, звуков больше. Если планируете озвучивать русский текст, проверяйте результат на коротком пробном фрагменте, прежде чем гнать весь ролик.
Совет: запишите тестовую фразу из пяти-шести слов и прогоните её первой. Так вы за минуту поймёте, как модель справляется с вашим языком и темпом, и не потратите время на длинный текст.
Голос: где взять озвучку, чтобы не испортить результат
Лицо может быть идеальным, но всё испортит звук. Есть два пути: записать свой голос на микрофон или взять синтез речи и получить готовый файл. Первый вариант честнее и живее, но требует тихой комнаты и хотя бы приличного микрофона — впрочем, современные смартфоны справляются.
🎙 Синтез речи удобнее, когда нужно много текста или несколько языков. Но здесь есть ловушка: голос звучит ровно и без эмоций, а лицо на видео всё равно реагирует. Получается странный контраст — мимика живая, интонация нет. Лечится это ручной правкой пауз и ударений.
Важно и качество записи. Шум, эхо, шипение — всё это модель может принять за часть речи и отразить в артикуляции. Записывайте в комнате с мягкой мебелью и шторами, держите микрофон в 15–20 сантиметрах от лица, говорите чуть медленнее обычного и не торопитесь.
И последнее: длину фраз. Одна фраза — один смысловой блок из 8–12 слов. Так и модели проще, и зрителю легче. Длинные периоды с запятыми в середине часто превращаются в рваную артикуляцию, особенно если вы читаете текст с листа без подготовки, как на школьном экзамене.
От стоп-кадра до видео 2K: что происходит внутри сервиса
Разберём путь целиком. Вы загружаете фото, выбираете, что с ним делать — оживить или сначала создать новые кадры с тем же лицом. Затем добавляете звук: загружаете файл или вводите текст для озвучки. Нажимаете кнопку и ждёте результат.
⚙️ Внутри сервиса фото проходит через детекцию, построение лица, генерацию движения и рендер в высоком разрешении. На каждом этапе модель проверяет, не «съехало» ли лицо, сохранились ли черты. Такой контроль нужен, чтобы на выходе человек остался похож на себя, а не на дальнего родственника.
Разрешение до 2K здесь не маркетинговая цифра. Именно оно решает, будет ли результат годиться для соцсетей и презентаций или останется экспериментом для личного архива. Мелкие детали — текстура кожи, блик в глазах, линия волос — проявляются только на высокой детализации.
ZUZU AI как раз работает по такой схеме: по фото человека генерирует новые изображения с его лицом до 2K и оживляет снимок в видео со звуком. Загружаете портрет, добавляете голос — и получаете говорящего человека на экране. Всё делается через сайт, без установки программ.
| Этап | Что происходит | Что нужно от вас |
|---|---|---|
| Детекция лица | Поиск ключевых точек на снимке | Фото, где лицо видно целиком |
| Построение модели | Достраивание объёма головы | Ракурс в камеру, ровный свет |
| Генерация движения | Артикуляция под звуковую дорожку | Аудиофайл или текст озвучки |
| Синхронизация | Совмещение фонем и формы губ | Короткие фразы по 8–12 слов |
| Рендер | Вывод результата до 2K | Немного времени на обработку |
Если не хочется разбираться с десятком инструментов, начните с ZUZU AI: там генерация новых кадров с вашим лицом до 2K и оживление фото в видео со звуком собраны в одном месте.
Пять сценариев, где говорящий портрет реально экономит время
Первый и самый очевидный — поздравления и личные сообщения. Вместо открытки с шаблонным текстом человек получает видео, где его близкий произносит тёплые слова. Особенно ценно, когда адресат далеко или когда удачное фото осталось только одно и снять новое невозможно.
🎬 Второй сценарий — контент для соцсетей. Блогеру не нужно каждый день садиться перед камерой: достаточно нескольких удачных портретов, чтобы выпускать регулярные ролики. Это не отменяет живых съёмок, но закрывает паузы, когда нет сил или времени на полноценный выпуск.
Третий — обучение и внутренние коммуникации. Инструкция, записанная голосом руководителя поверх его портрета, воспринимается внимательнее, чем страница текста. Четвёртый — музейные и исторические проекты: оживлённые архивные снимки превращают экскурсию в личный разговор. Для таких задач удобны сервисы вроде ZUZU AI, где один портрет превращается в серию видео с разным текстом.
Пятый сценарий — прототипы для рекламы и презентаций. Пока нет бюджета на съёмку с актёром, можно собрать черновик ролика, показать заказчику и уже потом идти в студию. Правда, в коммерческом видео стоит заранее договориться о правах на использование лица и голоса.
Типичные ошибки новичков и как их обойти
Ошибка первая — небрежное исходное фото. Смазанный кадр, глубокие тени под глазами, лицо, наполовину перекрытое рукой или волосами, — всё это модель честно перенесёт в видео и даже усилит. Пятнадцать минут на нормальный портрет экономят несколько кругов переделок.
⚠️ Ошибка вторая — длинный монолог на одном дыхании. Люди говорят короткими кусками, с паузами и вдохами, а начитанный вслух текст звучит ровно и безжизненно. Разбейте речь на фразы по 8–12 слов, добавьте паузы между блоками, дайте модели передохнуть.
Третья ошибка — экономия на звуке. Даже идеальная артикуляция не спасёт запись с эхом и шумом кухонной вытяжки. И четвёртая — попытка оживить лицо, снятое в профиль или в очках с тёмными стёклами: система не увидит опорных точек и начнёт фантазировать.
И пятая, самая обидная, — сразу гнать большой проект. Сделайте одно короткое видео, посмотрите на результат трезво, покажите кому-то ещё. Нейросети дают предсказуемо хороший результат на простых задачах и спотыкаются на нестандартных. Проверка на малом снижает риск.
Как выбрать исходное фото: короткий чек-лист
Начнём с главного: лицо должно быть видно целиком, от макушки до подбородка, и смотреть примерно в объектив. Лёгкий поворот на три-четыре градуса не страшен, а вот резкий профиль заставит модель додумывать половину головы, уши и линию шеи — результат станет спорным.
💡 Свет важнее мегапикселей. Ровное освещение без жёстких теней даёт модели чистый материал; вспышка в лоб делает лицо плоским, а контровой свет прячет глаза. Идеально — мягкий дневной свет из окна, чуть сбоку, без прямых солнечных лучей.
Проверьте фон и лишние детали: торчащие провода, пёстрый ковёр или случайные люди в кадре отвлекают и модель, и зрителя. Однотонный фон или размытая комната работают лучше всего, а руки и плечи в кадре помогают оживить картинку при движении.
И про качество файла. Возьмите оригинал, а не снимок экрана из мессенджера: сжатие убивает мелкие детали кожи и блики в глазах, а именно из них складывается ощущение реальности. Если фото старое и шумное, попробуйте мягко почистить его перед загрузкой.
Этика и согласие: о чём стоит помнить всегда
Технология нейтральна, а вот применение — нет. Оживить фото человека без его согласия, особенно публичного, — это прямая дорога к конфликту и, в некоторых случаях, к юридическим последствиям. Даже если формально это не запрещено, репутационно это работает против вас.
🔒 Отдельная тема — голос. Синтез речи по записи другого человека сегодня доступен, и соблазн велик. Но голос — часть личности, и подделка чужой интонации в ролике, который выглядит как настоящее видео, может быть воспринята как обман, а не как безобидная шутка.
Хорошая практика — спрашивать разрешение заранее и говорить прямо, что это видео, созданное нейросетью. Небольшая подпись «сгенерировано» не портит впечатление, зато снимает вопросы и защищает от неловких ситуаций. Люди ценят прозрачность сильнее, чем кажется.
И последнее — про архивные снимки и умерших родственников. Тема тонкая: для одного это способ сохранить память, для другого — болезненное вторжение. Если решаете делать такое видео, советуйтесь с семьёй. Технология позволяет многое, но не всё, что можно, стоит делать.
📚 Читайте также по теме «Видео со звуком»
✨ Попробуйте ZUZU AI
Создаёт новые фото по вашему лицу и оживляет снимки в видео — прямо на сайте, без установки программ. Результат в качестве до 2K.