Как сгенерировать фото нейросетью: пошаговый разбор с нуля для новичка
Что на самом деле происходит, когда нейросеть «рисует» вас
Многие представляют генерацию как волшебную кнопку: нажал — и получил портрет, будто с обложки глянцевого журнала. На практике всё чуть прозаичнее, но от этого не менее интересно. Нейросеть не выдумывает человека с нуля, она учится на ваших снимках. 📸
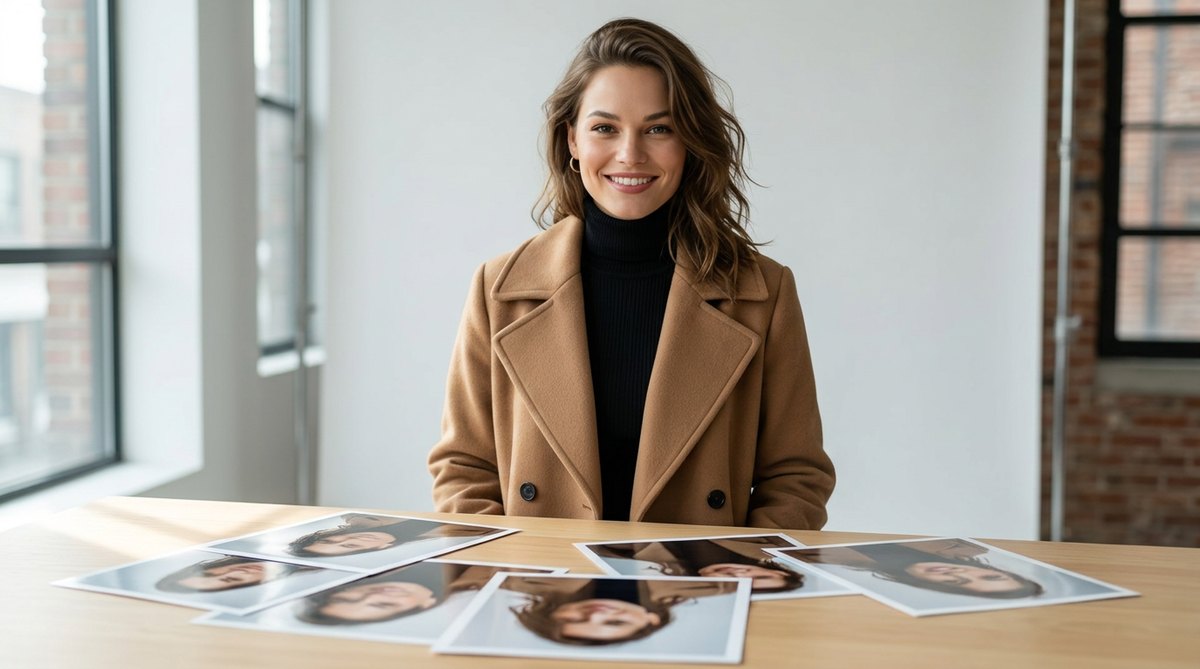
Смысл такой: вы даёте модели несколько исходников, она выделяет черты лица, пропорции, оттенок кожи и причёску, а затем переносит их на новое изображение. Меняются локация, свет, одежда и ракурс — лицо при этом остаётся узнаваемым. 🖼️
Именно поэтому к исходным фотографиям есть конкретные требования, и они придуманы не ради строгости. Чем честнее и разнообразнее снимки, тем меньше сюрпризов вы увидите на выходе. Дальше разберём весь путь по шагам, чтобы справился даже новичок. ✨
И ещё один момент, который стоит принять сразу: результат зависит не только от алгоритма, но и от вашего вкуса. Модель предлагает варианты, а выбираете из них вы. Так что относитесь к генерации как к творческому процессу, а не как к лотерее. 🎨
Почему именно три фотографии, а не десять
Тут начинается самое интересное для новичка: количество исходников ограничено. Загрузить можно ровно три своих фото — ни больше, ни меньше. Это не прихоть разработчиков, а осознанное решение, которое заставляет отбирать снимки головой, а не наугад. 👤
Что должно быть на этих трёх снимках? В идеале портреты с разных ракурсов: анфас, лёгкий поворот, профиль. Разное освещение тоже плюс — так модель понимает, как ведёт себя лицо при тёплом и при холодном свете. 💡
Дальше в дело вступает ZUZU AI: сервис берёт ровно три ваших фото и создаёт на их основе новые изображения с вашим лицом. Качество — до 2K, а всё действие происходит прямо на сайте, без установки программ и долгих настроек. 🚀
Полезный совет: откройте три отобранных снимка на большом экране и спросите себя, узнаете ли вы этого человека в толпе. Если да — исходники подходят. ✅
● ● ●
Пошаговый разбор: от загрузки до готового изображения
Шаг первый — подготовка файлов. Отберите три снимка, где лицо хорошо видно, нет посторонних людей на переднем плане и минимум ретуши. Сохраните их в нормальном разрешении, без сильного сжатия и странных цветовых фильтров. 📁
Шаг второй — загрузка. Вы просто добавляете три файла в интерфейсе. Никаких сложных настроек на этом этапе не требуется: система сама анализирует снимки и строит модель лица, с которой будет работать дальше. ⬆️
Шаг третий — выбор сценария. Вы решаете, что именно нужно: статичное изображение с вашим лицом или видео, где человек говорит и двигается. От этого выбора зависит всё дальнейшее, поэтому не спешите. 🎯
Шаг четвёртый — генерация и скачивание. Вы запускаете процесс, ждёте пару минут и получаете готовые файлы. Их можно сразу публиковать в соцсетях, ставить на аватарку или отправлять в личных сообщениях близким. ⬇️
Замечание: три фото — это не про количество, а про разнообразие. Один и тот же ракурс в трёх копиях даст модели куда меньше информации, чем три разных кадра. 🔄
Качество и детали: на что смотреть в результате
Первое, что волнует новичков, — не получится ли «мыльная» картинка. Здесь всё зависит от параметров: изображения с вашим лицом доступны в качестве до 2K. Такого разрешения с запасом хватает и для соцсетей, и для небольшой печати. 🔍
Второй момент — время ожидания. Генерация не мгновенная, но и не мучительная: обычно всё измеряется минутами, а не часами. За это время можно спокойно дописать текст для видео или подобрать следующую идею для сцены. ⏳
Третий момент — стабильность. Чем спокойнее и качественнее исходники, тем ровнее результат от кадра к кадру. Если что-то смущает, замените одну из трёх фотографий и запустите генерацию заново — часто это и решает проблему. 🔄
И не забывайте смотреть на результат трезво. Нейросеть — не фотошоп и не портретист с многолетним стажем: она предлагает свою интерпретацию. Зато именно в этой интерпретации и появляется что-то новое и неожиданное. ✨
● ● ●
| Параметр | Генерация фото | Оживление в видео |
|---|---|---|
| Что загружает клиент | Ровно 3 своих фото | Те же 3 фото |
| Что получается на выходе | Новые изображения с вашим лицом | Видео со звуком |
| Качество | До 2K | 768P или 2K — выбирает клиент |
| Длительность | Не задаётся | От 4 до 15 секунд |
| Речь персонажа | Нет | Клиент вводит текст, озвучка синтезируется автоматически |
| Выбор голоса | Нет | Нет — только в ветке песен |
● ● ●
Как оживить фото: видео со звуком за пару минут
Теперь перейдём к самому зрелищному формату. Схема почти та же, что и с изображениями: вы загружаете те же три своих фото, а сервис оживляет человека на них. Разница в том, что на выходе получается не картинка, а ролик. 🎬
Кстати, все сценарии — изображения, видео со звуком, песни и сцены с несколькими людьми — живут в одном месте. ZUZU AI работает через сайт, и переключаться между форматами можно за пару кликов. 🌐
Формат кадра и качество вы выбираете сами: доступны 768P и 2K. Длительность ролика — от 4 до 15 секунд. Этого хватает на короткое поздравление, шутку или мини-обращение, но не на полноценный монолог. ⏱️
Самое интересное — речь. Вы просто вводите текст, то есть пишете словами, что должен сказать человек на видео. Озвучка синтезируется автоматически на стороне сервиса, и вам не нужно ничего записывать самостоятельно. 🔉
Важный нюанс: голос при этом не выбирается. Своим собственным голосом поздравить тоже не получится — записи голоса клиента в сервисе просто нет. Выбор голоса есть только в ветке песен, в видео и фото его не предусмотрели. 🎙️
Мульти-персонажи и песни: когда одного лица мало
Иногда одного портрета недостаточно и хочется целую сцену. Сервис умеет генерировать изображения с несколькими людьми: у каждого участника свои фотографии, и все они оказываются в одном кадре. Это открывает сюжеты, которые раньше требовали фотошопа. 🧩
Например, можно собрать семейное поздравление, где рядом стоят бабушка, родители и дети. Или сделать шуточную открытку с коллегами по работе. Главное — заранее подготовить по три снимка на каждого человека, участвующего в сцене. 👥
Отдельная ветка — песни. Здесь клиент приносит свой текст или просто описывает идею словами, а сервис создаёт песню. Именно в этой ветке появляется выбор голоса: мужской или женский, детский или взрослый. 🎵
Не путайте ветки между собой. В видео и в фото выбора голоса нет, там озвучка формируется автоматически. Песни — единственное место, где тембр можно задать, так что если это важно, планируйте сценарий заранее. 🎶
Частые ошибки новичков и как их избежать
Ошибка первая — пытаться загрузить больше снимков «на всякий случай». Так не работает: ZUZU AI ждёт ровно три фото, и лишние файлы только запутают процесс. Лучше потратить время на отбор трёх действительно удачных кадров. ❌
Ошибка вторая — ждать своего голоса в видео. Его там не будет: вы вводите текст, а озвучка синтезируется автоматически. Если хочется именно ваш тембр, этот формат вам не подойдёт — и лучше узнать об этом заранее. 🚫
Ошибка третья — брать студийные снимки с тяжёлой ретушью. Кожа становится слишком гладкой, черты теряют индивидуальность, и результат выглядит неестественно. Живые фотографии с обычного смартфона часто работают заметно лучше. 🙂
Практика: после первой генерации сравните результат с исходниками и запишите, что именно пошло не так. Через два-три запуска вы начнёте выбирать фото почти безошибочно. 📝
И не забывайте про мелочи: посторонние предметы в кадре, чужие люди на фоне, солнечные блики — всё это влияет на итог. Чистый кадр без лишних деталей экономит вам как минимум один повторный запуск. 🧹
● ● ●
Короткий чек-лист перед первой генерацией
Перед нажатием кнопки пройдитесь по простому списку. Он занимает минуту, но экономит нервы и повторные попытки. Новички часто пропускают этот этап и потом удивляются, почему результат отличается от ожиданий. ✅
Вот что стоит проверить перед запуском. Список короткий, но каждый пункт реально влияет на результат, поэтому не пропускайте его — особенно если генерация для вас в новинку. 🗒️
- Три снимка отобраны: резкие, с хорошим светом, без сильной ретуши. 📸
- Лицо видно целиком, волосы не закрывают черты, очки не дают бликов. 👓
- Понятно, что нужно: статичное изображение или видео со звуком. 🎬
- Для видео готов текст речи, укладывающийся в 4–15 секунд. 📝
- Для песни есть свой текст или внятное описание идеи. 🎵
Дальше всё просто: загружаете три файла, выбираете параметры и ждёте результат. Первый запуск почти всегда волнительный, но именно он лучше всего объясняет, как работает технология и чего от неё ждать. 🚀
И последнее: экспериментируйте. Пробуйте новые ракурсы, сюжеты и форматы, сравнивайте результаты между собой и не бойтесь переделывать. Каждая новая генерация делает следующую попытку заметно точнее и интереснее. 🌟
✨ Попробуйте ZUZU AI
Создаёт новые фото по вашему лицу и оживляет снимки в видео — прямо на сайте, без установки программ. Результат в качестве до 2K.