Как сделать говорящее фото: синхронизация губ, озвучка и что влияет на естественность
Что такое говорящее фото и где его применяют
Говорящее фото — это обычный статичный снимок, который нейросеть превращает в короткое видео: человек на нём начинает моргать, поворачивать голову и произносить текст. Звук может быть вашим голосом, готовой записью или синтезированной речью. 🎬
Ещё несколько лет назад такое делали только в студии: с motion capture, трекингом маркеров и дорогим софтом. Сейчас хватает одного портрета и аудиофайла — всё остальное берут на себя генеративные модели. 📷
Сценариев применения много. Персональные поздравления для близких, говорящий аватар для соцсетей и мессенджеров, рекламный ролик без съёмочной группы, обучающее видео, оживление архивных семейных снимков. 🧩
При этом результат сильно разнится. На одном фото губы двигаются убедительно и лицо остаётся живым, на другом получается «пластилиновая» маска с дёрганой мимикой. Разница — в деталях, о которых мы и поговорим. 🔍
Как нейросеть синхронизирует губы со звуком
Работа начинается со звука. Нейросеть разбирает аудиодорожку на фонемы — минимальные звуковые единицы — и отмечает, в какой момент времени звучит каждая из них. Без этой разметки синхронизация невозможна. 🎧
Дальше фонемы сопоставляются с артикуляционными позами. Для «б», «п» и «м» губы смыкаются, для «а» рот широко раскрывается, для «ф» нижняя губа касается верхних зубов, для «ш» губы вытягиваются. 👄
На основе этого строится временная карта: каждому кадру будущего видео присваивается положение губ, языка и челюсти. Генератор дорисовывает лицо так, чтобы оно соответствовало этой карте кадр за кадром. 🧠
Параллельно модель должна сохранить самого человека: мимические морщины, родинки, форму носа, направление света. Если она увлекается артикуляцией и «забывает» про личность, появляются заметные артефакты. 🖼
Полезный совет: записывайте аудио в тихой комнате без эха и держите ровный темп речи. Чистая дорожка без фонового шума помогает синхронизатору точнее попадать в фонемы, и губы двигаются заметно естественнее.
Озвучка: почему голос важнее, чем кажется
Даже безупречная артикуляция не спасёт, если голос звучит роботом. Живая речь — это паузы, ускорения, лёгкие вдохи, случайные запинки и эмоциональные акценты на ключевых словах. 🎙
Синтез речи научился копировать тембр по короткому образцу. Обычно достаточно 10–30 секунд чистой записи, чтобы получить узнаваемый голос. Чем меньше в образце шума и эха, тем точнее получается клон. 🔊
Но интонация важнее тембра. Одна и та же фраза, произнесённая монотонно и ровно, убивает эффект присутствия, даже если губы двигаются идеально. Слушатель чувствует фальшь раньше, чем осознаёт её причину. 📈
Отдельный момент — ритм. Если аудио слишком быстрое или, наоборот, растянутое, синхронизатор начинает «плыть»: губы отстают от звука или убегают вперёд, и видео сразу теряет убедительность. 🎚
Что определяет естественность результата
Первый фактор — качество исходника. Резкий снимок в фас, с нейтральным выражением лица и мягким равномерным светом даёт куда более живой результат, чем размытое селфи в тени или профиль. 📸
Второй — движение головы. Когда человек говорит, он не сидит статуей: голова чуть покачивается, плечи подаются вперёд, взгляд смещается. Абсолютно статичная шея при активной артикуляции выглядит жутковато. 🌀
Третий — микромимика. Брови, веки, уголки губ и крылья носа живут своей жизнью. Именно эти мелочи отличают живое видео от «оживлённой фотографии» с пустым остановившимся взглядом. 👁
| Фактор | Что портит результат | Как улучшить |
|---|---|---|
| Исходное фото | Размытие, шум, жёсткие тени, профиль | Резкий портрет в фас при мягком свете |
| Аудиодорожка | Эхо, фоновый шум, скачки громкости | Тихая комната, ровный темп, чистая запись |
| Ритм речи | Слишком быстрая или рваная подача | Короткие фразы с осмысленными паузами |
| Разрешение | Дрожание кадров, рябь на коже | Вывод в высоком качестве без фильтров |
| Эмоция в кадре | Каменное лицо при весёлом тексте | Подбирать снимок под настроение реплики |
Какое фото подойдёт лучше всего
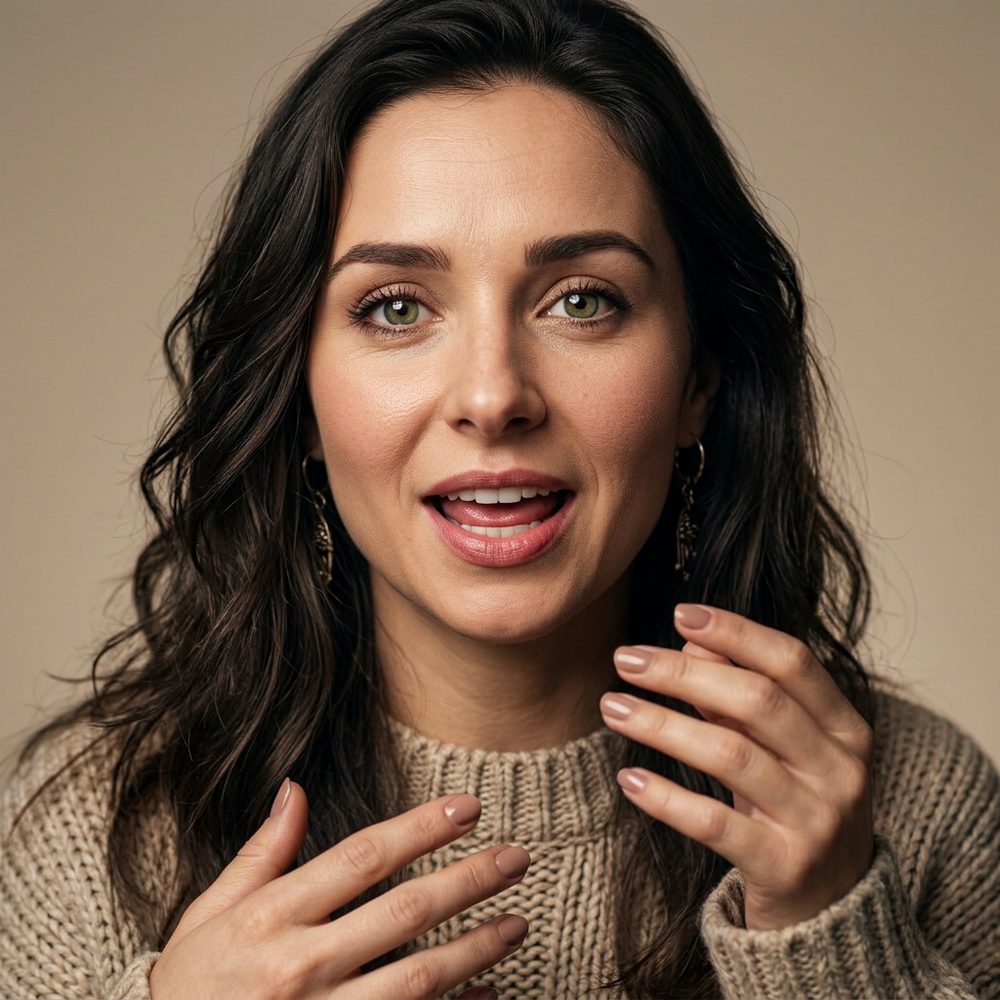
Идеальный кандидат — портрет, где лицо занимает большую часть кадра, смотрит прямо в объектив и ничем не перекрыто. Очки, шарф у подбородка и пряди волос на щеках усложняют работу модели. 🖼
Освещение должно быть мягким и однородным. Жёсткие тени от окна или лампы создают контраст, который нейросеть переносит на каждый кадр и усиливает — лицо начинает выглядеть грязным и неровным. 💡
Рот лучше держать закрытым или слегка приоткрытым, без широкой улыбки с зубами. Модель будет достраивать артикуляцию, и сильная исходная эмоция начнёт конфликтовать с новыми движениями. 🙂
Разрешение исходника тоже важно. Снимок из мессенджера с сильным сжатием почти всегда даёт мыло и артефакты, а качественный портрет позволяет вывести видео в высоком разрешении без потери деталей. 📐
Ошибки, которые выдают генерацию
Первая частая ошибка — слишком длинный текст. Одна реплика на 10–15 секунд работает отлично, а вот на минуту лицо успевает «поплыть»: появляются дрожь, деформации и постепенная потеря сходства. ✂️
Вторая — несовпадение интонации и выражения лица. Весёлый рассказ на фото с каменным взглядом читается как пародия. Подбирайте снимок под настроение фразы или делайте сам текст более нейтральным. 🎭
Третья — экономия на звуке. Синтезированный голос без пауз и дыхания звучит гладко, но безжизненно, и мозг зрителя мгновенно считывает подвох, даже если картинка получилась удачной. 🎧
Четвёртая — перебор с эффектами. Фильтры, резкость, виньетки и агрессивная цветокоррекция поверх генерации только подчёркивают несовершенства. Лучше оставить кадр максимально чистым и естественным. 🚫
Пошаговый порядок работы над говорящим фото
Сначала подберите фото и приведите его в порядок: обрежьте по грудь, выровняйте горизонт, уберите лишний шум. Никаких тяжёлых фильтров — они только усложнят работу модели. 🧰
Затем подготовьте текст и озвучку. Прочитайте реплику вслух пару раз, найдите комфортный темп, запишите её в тишине или выберите подходящий синтезированный голос с нужной интонацией. 🎤
Дальше загрузите материалы в сервис — например, в ZUZU AI — и запустите генерацию. На этом этапе стоит сделать короткий тестовый прогон на 5–8 секунд, чтобы понять, как ведёт себя лицо и попадают ли губы в звук. 🔄
И только после удачного теста собирайте полную версию. Такой подход экономит время: вместо десяти неудачных длинных роликов вы получаете один аккуратный, предсказуемый и действительно живой. ✅
Как оценить результат и куда двигаться дальше
Готовое видео смотрите дважды: без звука и со звуком. Без звука заметны дрожание, деформации и «кипящие» участки кожи, со звуком — рассинхрон и неестественные паузы. 👀
Полезно показать результат человеку, который не знает, как он сделан. Свежий взгляд сразу замечает то, к чему вы привыкли за время работы: странную шею, слишком ровные зубы, застывший взгляд. 🧐
Если хочется большего качества, экспериментируйте с длиной реплик, темпом и выбором исходного снимка. Часто именно замена фото даёт куда больший прирост, чем любые настройки внутри сервиса. 📊
Попробовать такой формат можно на ZUZU AI — нейросеть по вашему фото генерирует новые изображения с сохранением лица и оживляет снимки в видео со звуком. Загружаете портрет и аудио — и получаете говорящее фото. 🚀
ZUZU AI работает через сайт zuzu-ai.ru: одна фотография превращается и в новые изображения с вашим лицом, и в говорящее видео со звуком. Удобно, когда нужно быстро собрать контент без съёмок, студии и долгой постобработки.